Нейросеть для видео из фото нужна, когда хочется загрузить снимок и получить короткий ролик, где что-то двигается. Почти весь контент на эту тему устроен одинаково: список из десятка сервисов с плюсами и минусами, а объяснения, что вообще происходит между загрузкой фото и готовым видео, нет почти нигде.
Понимание механики полезнее конкретного названия сервиса: интерфейсы и тарифы меняются каждые несколько месяцев, а принцип, по которому нейросеть додумывает движение из одного кадра, остается тем же независимо от того, какой сервис его реализует. Разобравшись один раз, проще оценить любой новый инструмент, который появится на этом рынке позже.
Что делает нейросеть, когда превращает фото в видео
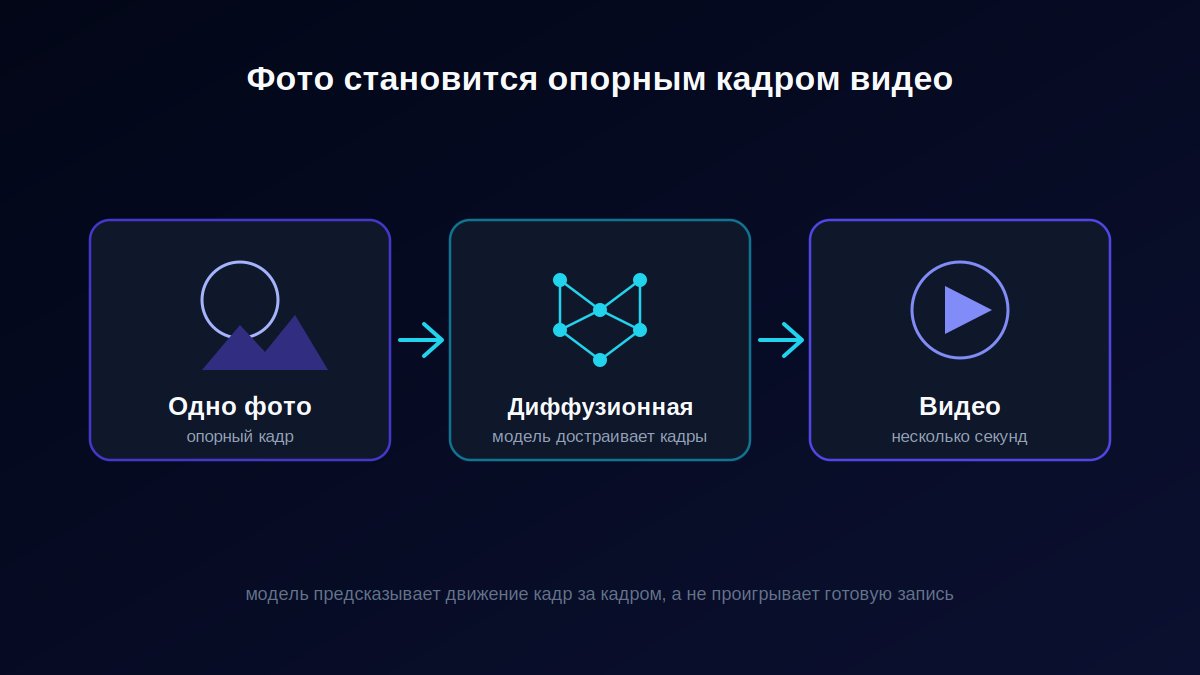
Нейросеть для видео из фото — это генеративная модель, которая рисует заново каждый кадр будущего ролика по исходному фото. Технически в основе почти всех современных сервисов лежит диффузионная модель: тип нейросети, которая учится сначала разрушать изображение шумом, а потом восстанавливать из шума правдоподобную картинку. Генерация видео — это тот же принцип, только для последовательности кадров, которые должны быть согласованы между собой.
Исходное фото в этой схеме работает как первый кадр видео, если говорить простыми словами. Официальное описание модели Stable Video Diffusion от Stability AI прямо называет ее «диффузионной моделью, которая принимает статичное изображение как опорный кадр и генерирует из него видео». Дальше модель предсказывает весь ролик целиком, с оглядкой на то, что уже случилось в уже сгенерированных кадрах. Иначе человек на видео на третьей секунде оказался бы в другой рубашке, чем на первой.
Ключевое отличие от анимации или гифки в том, что сеть додумывает движение с нуля. У обычной анимации есть заранее заданная последовательность кадров: художник или программа знает наперед, что будет происходить. У нейросети такой заготовки нет. Она предсказывает, как, скорее всего, будет выглядеть сцена через долю секунды, опираясь на миллионы видео, которые видела при обучении. Предсказание иногда ошибается, и получаются артефакты.
Архитектурно видеомодели почти всегда берут уже обученную модель для картинок и добавляют в нее временные слои: механизм, который связывает соседние кадры друг с другом, чтобы движение выглядело плавным и цельным. Без этих слоев модель просто не знала бы, что кадр двенадцать должен быть похож на кадр одиннадцать, даже если оба изображают одну и ту же сцену. Согласованность кадров во времени сложнее одной красивой картинки: видео требует от модели больше «знаний о мире».
Причина в объеме и качестве обучающих данных. Хороших изображений в интернете для обучения моделей накоплено огромное количество, а вот качественного, высокоразрешенного видео заметно меньше, и оно тяжелее по объему на единицу контента. К тому же у видеомодели есть дополнительная задача: кадры нужно согласовывать между собой на протяжении нескольких секунд, чтобы лицо, одежда и предметы не менялись от кадра к кадру.
Что происходит под капотом: пайплайн по шагам
Если разложить генерацию на этапы, получится цепочка, общая для большинства сервисов image-to-video.
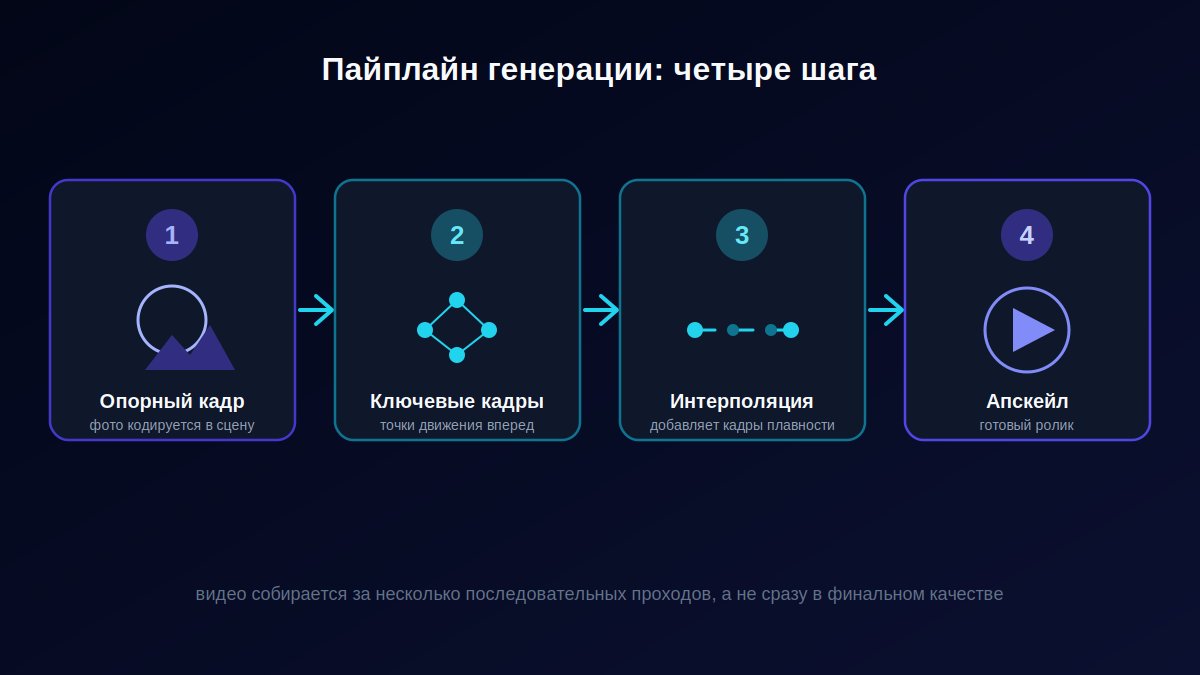
Первый шаг: фото становится опорным кадром. Модель кодирует изображение в свое внутреннее представление, то есть сжатое описание того, что на картинке: объекты, их примерное расположение, освещение.
Второй шаг: генерация опорных кадров вперед по времени. В общей схеме каскада модель сначала намечает более редкие ключевые точки движения. Runway обучает Gen-3 Alpha на подробных по времени описаниях, что дает точную расстановку ключевых кадров элементов сцены. Проще говоря, ролик строится от главных точек движения к промежуткам между ними.
Третий шаг: заполнение промежуточных кадров для плавности. Между редкими опорными точками нужно достроить кадры, которые их соединяют, иначе движение будет дерганым, как слайд-шоу. У Google в описании исследовательской модели Imagen Video этот этап называется временной суперрезолюцией: отдельная модель добавляет недостающие кадры между уже сгенерированными, повышая частоту кадров в секунду до плавного видеоряда.
Четвертый шаг: повышение разрешения и сведение в готовый ролик. Сама генерация часто идет в низком разрешении, чтобы сначала собрать движение, а затем отдельная модель повышает детализацию картинки до финального качества. У Imagen Video этот этап называется пространственной суперрезолюцией. Технология каскадная: итоговое видео собирается из нескольких последовательных проходов.
Каскад позволяет сначала собрать движение в низком разрешении, а затем довести картинку до нужной четкости. Пользователь на выходе получает готовый ролик за секунды или минуты, хотя внутри система успела прогнать изображение через несколько отдельных моделей подряд. Каждый следующий проход добавляет то, чего не хватало предыдущему: сначала движение, затем кадры между ключевыми, затем детали.
Через всю эту цепочку проходит одна и та же техническая проблема: согласованность кадров во времени, или temporal consistency. Это способность модели держать стабильными объекты, лица, текстуры и освещение от кадра к кадру, не давая картинке поплыть. Связь между соседними кадрами приходится закладывать отдельными механизмами, и именно она чаще всего дает сбой на длинных или перегруженных деталями роликах.
Какие типы движения умеет нейросеть для видео из фото
Не всякое оживление фото одинаковое. Сервисы умеют несколько разных видов движения, и они по-разному нагружают модель с точки зрения риска ошибиться.
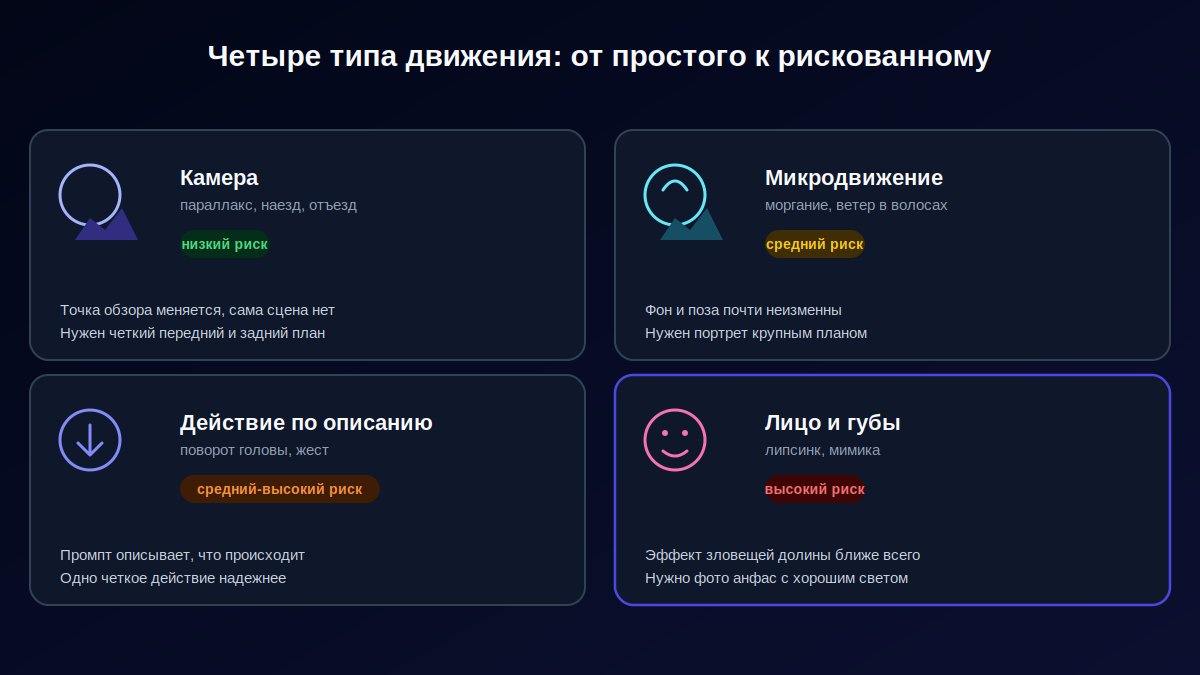
Первый тип: движение камеры без изменения содержимого кадра. Легкий наезд, отъезд или панорама, которая создает эффект глубины на плоском фото, когда передний план как будто сдвигается быстрее заднего. Такое движение проще для модели технически, потому что объекты в кадре не меняют форму: меняется только точка обзора. Для такого эффекта важно, чтобы на фото были четкий передний и задний план: тогда ясно, что ближе к камере, а что дальше, и передний план может смещаться относительно заднего.
Фото пейзажа с четким разделением на передний и задний план хорошо подходит для параллакса: границы объектов видны. Фото без выраженной глубины, вроде документа или скриншота экрана, для такого движения подходит хуже: разделять на планы там нечего. Перед запуском полезно посмотреть на фото глазами модели: где передний план, где задний и есть ли между ними заметная граница.
Второй тип: естественное микродвижение. Медленное моргание, легкое покачивание волос от ветра, едва заметное дыхание. Это тот класс движения, который делает портрет живым, не превращая его в мини-фильм: фон и поза остаются почти неизменными, двигаются только мелкие детали, а результат выглядит естественно даже без точного текстового описания.
Третий тип: направленное движение по короткому описанию. Промпт задает, что именно должно произойти в кадре: человек поворачивает голову, поднимает руку, улыбается. Фото задает сцену, а текст описывает, что в ней происходит дальше. Короткое и конкретное описание с одним четким действием обычно работает лучше, чем связка из нескольких разных движений в одном промпте. Если нужно несколько действий, их лучше разбить на отдельные генерации.
Четвертый тип: анимация лица и губ, один из самых сложных по артефактам. Синхронизация губ с речью или музыкой сама по себе технически неплохо отработана к 2026 году, но вокруг нее остается много проблем. Застывшая мимика и рассинхрон между тоном голоса и выражением лица: все это легко заметить в готовом ролике. Сложной остается именно мимика вокруг рта, даже когда сама синхронизация технически точна. Если нужно просто оживить портрет, начни с самого простого движения и усложняй задачу только при необходимости. Для легкого оживления портрета подходит готовый шаблон «Оживить фото».
| Тип движения | Что нужно от фото | Ориентир по риску артефактов |
|---|---|---|
| Камера (параллакс, наезд) | Четкий передний и задний план | Ниже |
| Естественное микродвижение | Портрет крупным планом | Умеренный |
| Направленное движение по описанию | Понятная поза, свободное пространство в кадре | Умеренный, выше на сложных сценах |
| Анимация лица и губ | Фото анфас, хорошее освещение лица | Выше |
Именно на границе между легким естественным движением и точной анимацией лица работает большинство готовых шаблонов вроде тех, что стоят за pixvibe. Шаблоны pixvibe строятся вокруг первых двух типов движения: это плавное, узнаваемое движение, которое проще предсказать и легче оценить на глаз.
Где технология ломается: артефакты и ограничения
Первое: деформация рук и мелких деталей. Это один из самых заметных провалов генеративного видео. Обычно это связывают с тем, что диффузионные модели работают со статистикой пикселей и ничего не знают об устройстве предметов: число пальцев у кисти для них лишь вероятность. Так же часто страдают надписи в кадре, мелкие аксессуары и форма предметов. Если руки в кадре можно оставить неподвижными или убрать из него, лучше так и сделать. Чем длиннее и насыщеннее деталями сцена, тем сложнее модели удержать их форму и взаимное расположение между кадрами.
Второе: перегруженные сцены системно ломают результат. Толпа людей, много техники и множество одновременно движущихся деталей в кадре заметно повышают риск искажений. Логика простая: чем больше объектов модель должна одновременно удержать согласованными между кадрами, тем выше шанс, что хотя бы один из них поплывет на второй или третьей секунде. Та же логика распространяется на текст и логотипы в кадре: буквы состоят из тонких мелких деталей, которые модель воспроизводит на каждом кадре заново, поэтому текст и логотипы нередко искажаются.
Третье: отражения — это отдельная слабая точка диффузионных моделей. Проверка на статичных кадрах показала, что Stable Diffusion 2.1 не справляется с правдоподобными отражениями в зеркалах. На видео, по аналогии, проблему усугубляет движение камеры: отражение должно синхронно меняться вместе с ракурсом.
Четвертое: чем длиннее ролик, тем сильнее дрейф. Короткие клипы обычно держат консистентность лучше, а с ростом длительности лицо, одежда и форма предметов «плывут» заметнее. По наблюдениям, к концу ролика сцена удерживается хуже, чем в начале. Многие сервисы ограничивают одну генерацию несколькими секундами и наращивают длительность склейкой отдельных клипов.
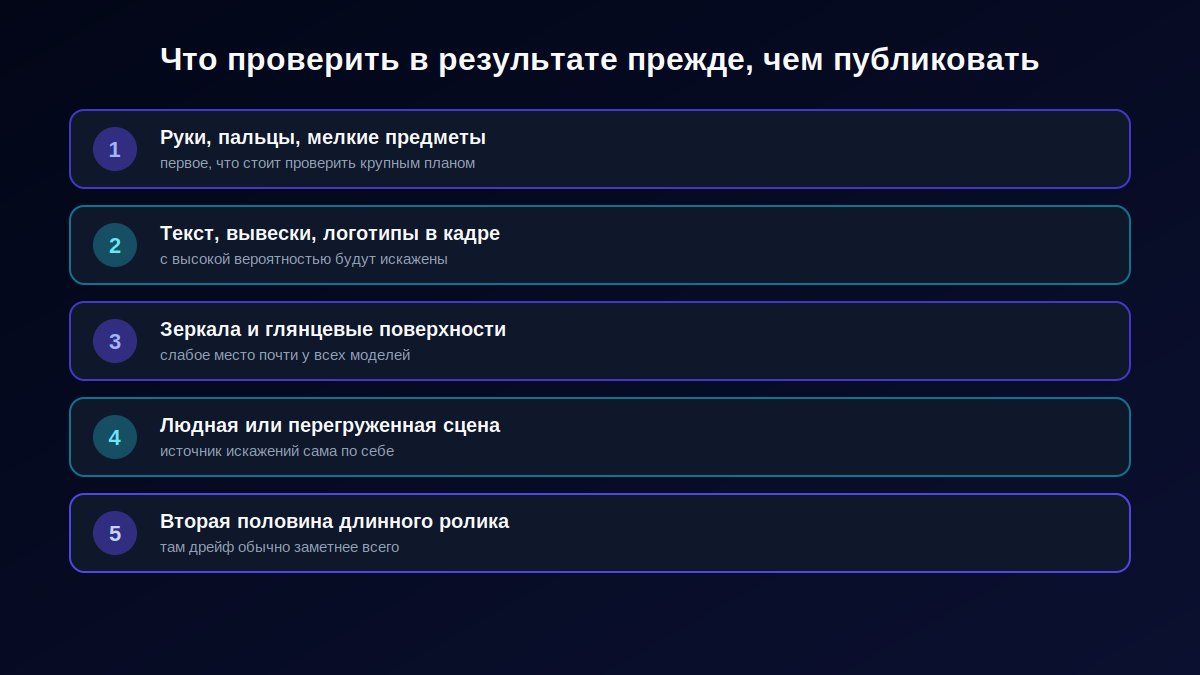
Перед публикацией ролика проверь в результате:
- руки, пальцы и мелкие предметы в кадре: первое, что стоит проверить крупным планом;
- любой текст, вывеска или логотип в кадре: нередко искажаются;
- зеркала и глянцевые отражающие поверхности: отражения часто искажаются;
- людная или перегруженная деталями сцена: источник искажений сама по себе;
- вторая половина ролика у длинных клипов: там дрейф обычно заметнее всего.
Кому это подойдет за один тап, а кому нужен ручной промптинг
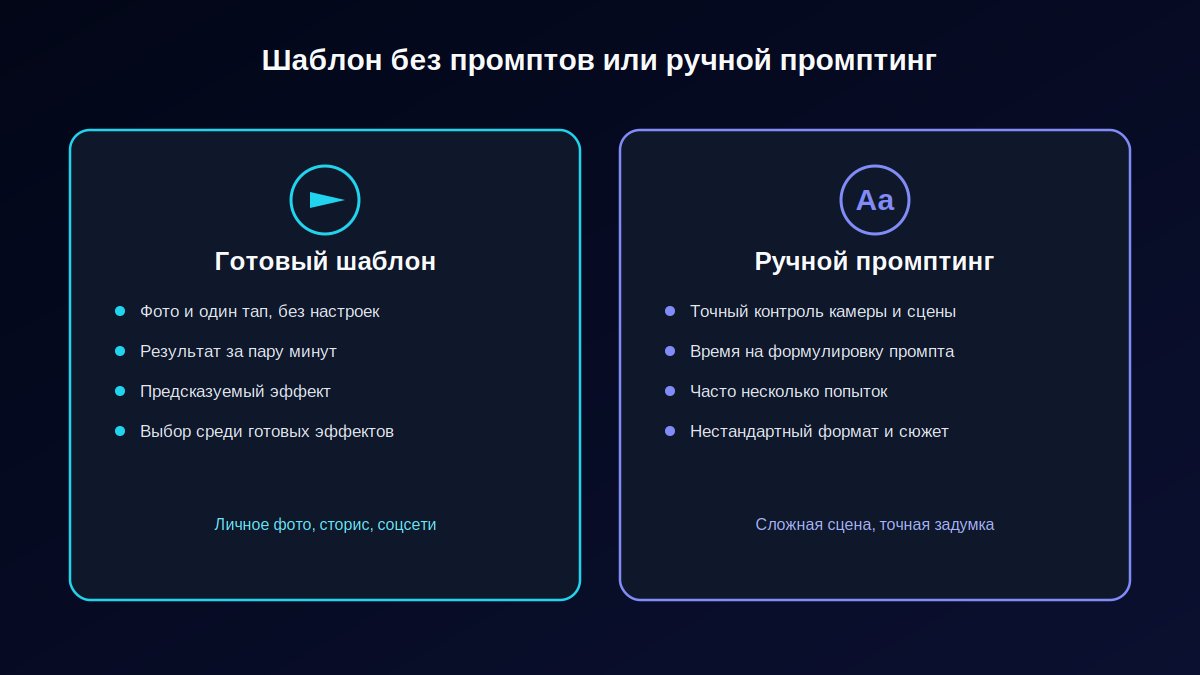
Выбор зависит от того, что нужно на выходе.
Готовый шаблон без промптинга закрывает большинство мобильных сценариев. Личное фото для сторис, легкое оживление портрета, короткий ролик для соцсетей: здесь не нужен точный контроль над камерой и сценой, нужен предсказуемый результат за минимум действий. Именно так работают шаблоны вроде тех, что стоят за видео из фото на pixvibe. Промпт и модель уже подобраны под конкретный эффект, от пользователя нужны фото и один тап.
Ручной промптинг в большой нейросети нужен, когда важен точный контроль: конкретное движение камеры, нестандартный формат, сложная многоплановая сцена с определенным сюжетом. За этот контроль приходится платить временем на формулировку промпта и часто несколькими попытками, если результат с первого раза не совпал с задумкой.
У самого формата фото в видео есть ограничения: результат обычно короче, чем ожидают, и на него нужны отдельные кредиты. Бесплатные лимиты у сервисов небольшие. У Runway, например, бесплатный план дает разово 125 кредитов на знакомство с инструментами, а у Pika это 80 кредитов в месяц. Это стоит держать в голове заранее, до третьей неудачной попытки, когда кредиты уже кончились: первые попытки лучше тратить на самые удачные фото.
Портрет одного человека дает стабильнее результат, чем групповое фото, потому что меньше объектов нужно одновременно удержать согласованными между кадрами, а значит меньше шансов на артефакт. Если задача снять группу друзей, лучше заложить пересъемку результата и несколько попыток генерации: так проще выбрать вариант, где никто из людей не поплыл.
Нейросети для видео из фото в 2026 году: короткий ориентир
Компактный ориентир, куда смотреть, если хочется попробовать сервис с ручным промптингом.
| Сервис | Доступ | Для чего лучше подходит |
|---|---|---|
| Kling AI | По сообщениям пользователей, есть бесплатный лимит с суточным обнулением; условия оплаты из России лучше уточнить на сайте сервиса | Кинематографичное движение, консистентность персонажа между кадрами |
| Runway | Бесплатно: 125 разовых кредитов и 5 ГБ хранилища; условия платного доступа из России лучше уточнить на сайте сервиса | Контролируемое движение камеры и параллакс поверх статичного фото |
| Luma Dream Machine | Есть бесплатный стартовый тариф; условия платного доступа из России лучше уточнить на сайте сервиса | Коммерческая работа с высокой требовательностью к консистентности объекта |
| Pika | Бесплатно: 80 кредитов в месяц, разрешение только 480p | Быстрые вирусные видеоэффекты и трендовые форматы для соцсетей |
| Google Veo | Только платная подписка Google AI; доступность из России лучше уточнить | Кинематографичный контент со звуком, реклама и продакшн-сценарии |
| Hailuo (MiniMax) | По сообщениям пользователей, есть бесплатный дневной лимит генераций | Фотореалистичные ролики с удержанием внешности персонажа |
| Wan AI (Alibaba) | Открытая лицензия Apache 2.0, бесплатна для личного и коммерческого использования | Разработчикам и техподкованным пользователям, которым нужен полный контроль |
Выбор конкретного эффекта в этом списке имеет смысл сверять с тем, что вообще сейчас в ходу: разбор актуальных фото-трендов соцсетей поможет понять, какой тип движения сейчас откликается лучше.
Sora от OpenAI, сервис, который еще недавно был у всех на слуху, прекращает существование для обычных пользователей 26 апреля 2026 года, а его API по объявленному графику отключается 24 сентября 2026 года. Прежде чем вкладывать время в освоение конкретного инструмента, стоит проверить его актуальность на официальном сайте.
У большинства крупных нейросетей бесплатный тариф означает укороченную длительность, более низкое разрешение и водяной знак на видео. Условия быстро меняются, перед использованием их стоит сверить на сайте сервиса. Бесплатный тариф удобен, чтобы оценить качество на одном-двух фото до оплаты.
При выборе сервиса из этого списка не гонись сразу за самой мощной моделью с самой длинной очередью ожидания и сложным интерфейсом. Для разового личного видео проще и быстрее начать с сервиса, у которого бесплатный тариф дает результат за пару минут без долгой регистрации, и только если этого качества не хватает, переходить к более требовательным инструментам с ручным промптингом и платной подпиской.
Как сделать видео из фото без промптов: пошагово
Если писать промпт совсем не хочется, вместо него можно взять готовый шаблон под нужный результат. Это другой подход: промпт и модель уже подобраны разработчиком заранее под конкретный эффект, и от пользователя требуется только исходник и выбор формата.
Пошагово это выглядит так:
- выбрать фото: портрет анфас или в три четверти, четкое, без резких теней и лишних людей в кадре;
- выбрать шаблон под нужный формат ролика: легкое оживление, движение камеры или направленное действие;
- дождаться результата: обычно это минуты, без подбора промпта и повторных попыток.
Лучше брать четкое фото, где лицо и руки видны полностью, а фон не сливается с фигурой: качество исходника влияет на результат. Хорошее освещение лица и четкий, не смазанный кадр помогают еще до начала генерации: модели просто не приходится домысливать детали, которых на фото не видно из-за тени или размытия. По той же причине стоит избегать фото, где человек частично закрыт посторонним предметом или другим человеком, обрезан по краю кадра или снят под сильным углом. Каждая из этих особенностей заставляет модель угадывать больше, чем она может уверенно предсказать, а угадывание и есть источник артефактов.
Бесплатные кредиты тратятся с каждой попыткой, поэтому фото и шаблон лучше выбрать заранее. Ролик получится коротким, на несколько секунд, полноценный клип с сюжетом не выйдет. Таковы пределы самой технологии на 2026 год.
У pixvibe шаблон «Видео из фото» устроен именно по этой логике, без ручного промптинга, с готовым эффектом под конкретный результат. Сервис сейчас на предзапуске, генерация открывается по вейтлисту, но попробовать шаблон и встать в лист можно уже сейчас. Если задача проще, просто оживить портрет легким естественным движением без полноценного видеоряда, для этого есть отдельный разбор: как оживить фото. А готовый ролик потом легко превратить в контент для соцсетей: форматы для этого разобраны отдельно в подборке идей для Reels из одного фото.
Частые вопросы
Можно ли создать видео из фото бесплатно? Да, у большинства крупных сервисов есть бесплатный лимит или пробный режим, но почти всегда с ограничением по длительности, разрешению и водяным знаком на готовом видео. Точные условия у каждого сервиса свои и быстро меняются, перед использованием их стоит сверить на сайте сервиса.
Можно ли сделать видео из фото с музыкой? Обычно да, но музыка или озвучка чаще добавляются отдельным шагом уже после генерации видео. Исключение составляют сервисы с нативной генерацией звука и липсинком, но это уже отдельная и более сложная задача, чем простое оживление фото.
Почему видео из фото получается коротким? Это техническое ограничение. Чем длиннее генерируемый ролик, тем сильнее размывается согласованность между кадрами, и по наблюдениям результат «плывет» тем заметнее, чем дальше от начала.
Нужна ли платная подписка, если хватает бесплатного лимита? Не всегда. Если задача разовая, оживить одно фото для истории в соцсети, бесплатного лимита большинства сервисов достаточно. Платная подписка оправдана, когда нужна стабильная скорость генерации, разрешение выше 720p или отсутствие водяного знака на регулярной основе.
Почему на одном и том же фото результат у разных сервисов сильно отличается? Каждая модель обучена на своем наборе видео и по-своему справляется с согласованностью кадров. Одна и та же фотография может дать плавный результат в одном сервисе и заметный артефакт в другом просто потому, что модели по-разному «додумывают» движение.
Можно ли оживить рисунок или картину? У части сервисов такая возможность заявлена отдельно, но результат обычно менее предсказуем, чем на реалистичном фото. С рисованными персонажами и нестандартной анатомией движение может получиться неожиданным.
Нужен ли мощный компьютер или специальное приложение для генерации видео из фото? Нет, вся тяжелая часть считается на серверах сервиса. Для запуска генерации достаточно браузера на телефоне или компьютере: загрузить фото, выбрать шаблон или написать промпт и дождаться готового ролика.
Коротко: как сделать
Нужен результат за пару минут без промптов: открой готовый шаблон, загрузи фото анфас без резких теней и лишних людей в кадре, дождись результата. Нужен точный контроль над камерой и сценой: иди в большую нейросеть с ручным промптингом (Kling, Runway, Luma, Veo) и закладывай время на формулировку промпта. Результат не устроил с первого раза: проверь руки, текст в кадре и вторую половину ролика: эти три точки стоит смотреть в первую очередь.
Если формат «выбрал шаблон, загрузил фото, получил результат» ближе, чем разбор промптов и настроек камеры, шаблон «Видео из фото» на pixvibe сейчас открыт для вейтлиста: можно попробовать и встать в очередь на генерацию заранее.